Windows x64 · NVIDIA GPU · Whisper FP16 本地识别版

把视频里真正说过的话,完整恢复出来

选择视频、音频、图片或整个混合文件夹,在电脑上使用 Whisper Medium FP16 和 OCR 完成本地识别与资料导出。
Windows 10/11 x64 · 安装包约 100 MB · 必需组件约 3.14 GiB · 当前未签名
这是 Validation Build 4 候选 测试版最低需要 NVIDIA 8 GB 显存运行 Medium FP16;本候选已包含图片 OCR 与视频关键帧 OCR,Large-v3 不参与默认交付。脱水文本和阅读理解仍在后续版本实现。
Validation Build 4 的本地 GPU 与 OCR 处理路径
本地模式 · 视频不会上传
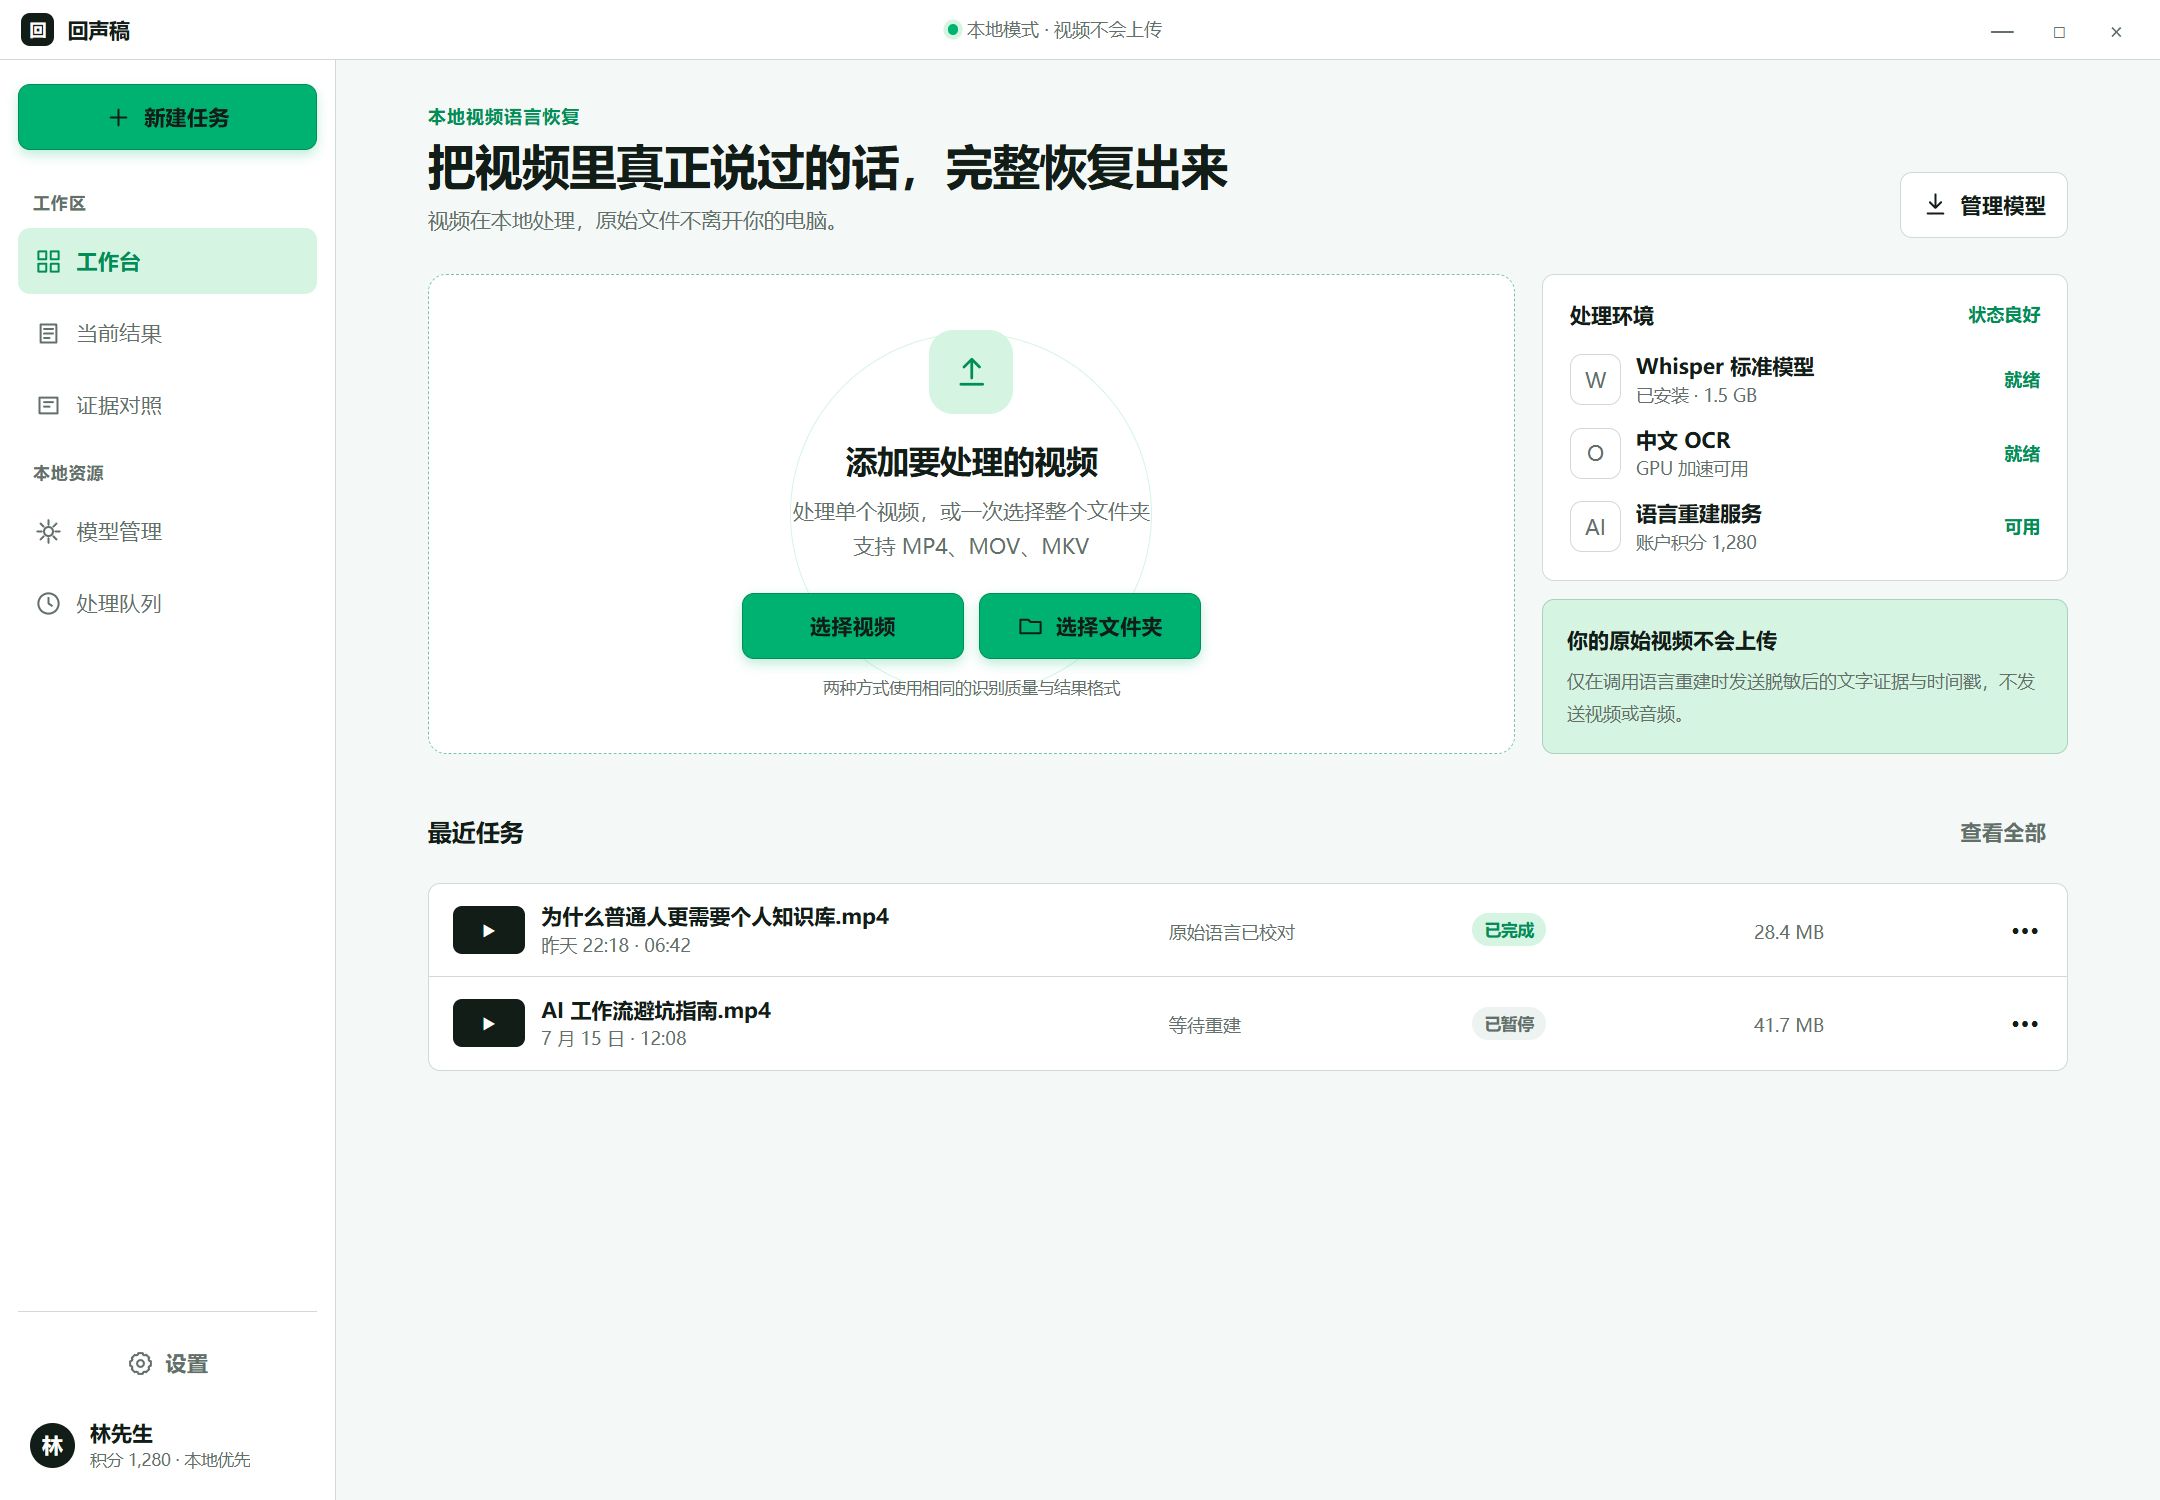
回声稿桌面工作台 Prototype,包含单视频与选择文件夹入口、处理环境和最近任务
先选择输入方式 单个视频和整个文件夹是同等级入口,使用相同的识别质量与结果格式。
01 / 产品路线

从文件到可引用的文字,没有绕路

以下是正在实现的正式功能路线:先保留真实表达,再提高阅读效率。

01

导入视频

处理单个视频,或一次选择整个文件夹。任务开始前先检查文件与处理规则。

02

本地识别

音频、画面字幕和时间轴在电脑上完成识别,过程状态清楚可见。

03

逐句校对

原话与同期音频、画面字幕相互对照,不确定之处明确标记。

04

导出结果

切换原始语言、脱水文本和阅读理解,按需要保存最终文档。

忠实恢复优先于语言美化。每一次整理,都能回到原始表达。 原始语言 → 脱水文本 → 阅读理解
02 / 批量处理 · 已可用

一个文件夹,也会是一项完整任务

应用会先扫描、再确认队列。当前按顺序处理,每个视频独立保存,单项失败不会拖住其余任务。

  • 扫描文件夹并检查可处理视频
  • 单并发稳定处理,后续开放并发设置
  • 失败隔离,可单独重试或打开结果
课程视频 / 第三期 3 / 12 个视频
01 为什么普通人更需要个人知识库.mp4
已完成
02 AI 工作流避坑指南.mp4
处理中
03 从收藏到真正使用知识.mp4
等待中
04 一个人如何建立内容系统.mp4
可重试
已完成的结果会立即保存,无需等待整个队列。 仅重试失败项
03 / 结果与证据 · 开发中

每一句,都能回到它的证据

正式功能版计划在左侧看视频、中间校对逐句原话、右侧查看同期识别证据。AI 负责恢复,不负责随意润色。

已保存 · 原始语言 · 句段 18 / 48
视频预览02:20
比如我之前用 Coze 做过一个工作流,字幕里写的是“扣子”。
逐句原始语言48 个句段
你不是缺少信息,你缺少的是一个能反复调用的系统。
比如我之前用 Coze 做过一个工作流,字幕里写的是“扣子”。
真正有价值的是,以后遇到同一类问题,它能告诉你上次怎么解决。
所以啊,先别急着搭一个特别复杂的知识库。
一份事实底稿,两种阅读方式。 脱水文本只去除无信息冗余;阅读理解以原始语言稿为事实依据。
04 / 正式功能版隐私边界

视频在本地处理,原始文件不离开你的电脑

Prototype 0.4 RC1 在本机读取所选文件并完成音频提取和 GPU 语音识别,不上传视频、音频或识别结果。

原始视频与音频保留在你的电脑 本地
音频与字幕识别在设备上完成 本地
识别模型按需下载与管理 可控
语言重建只使用脱敏文字证据 最小化
05 / 下载

下载回声稿,开始第一段本地识别

当前仅提供 Windows 10/11 x64 RC。应用会自动下载 FFmpeg、独立 CUDA 12.4 GPU Worker 和 Whisper Medium FP16;12 GB 显存设备可选装 Large-v3 FP16。

未进行 Authenticode 代码签名,Windows SmartScreen 可能显示“未知发布者”。请从本站下载并核对发布后的 SHA-256。
Windows 安装包 SHA-256D1E0CD24E13FA266B576E5B289BA74C4A658A96D6576212B17F86F0F1AACBADD
Validation Build 4 候选 现在能做什么?

可以选择视频、音频、图片或递归扫描混合文件夹,自动安装五项本地组件,使用 Medium FP16 识别语音并使用 OCR 提取图片和视频关键帧文字。任务支持持久化、取消、失败隔离、重试和资料导出。

回声稿会上传我的视频吗?

当前版本会读取本地文件信息以创建任务,但不会上传视频、音频或图片。语音识别和画面文字识别均在本地完成。

可以直接处理整个文件夹吗?

可以。应用会递归扫描所选文件夹,为受支持的视频、音频和图片分别建立任务,隔离失败并按队列进行本地处理。

会生成哪些文档?

当前会生成真实的原始语言识别结果,可导出 SRT、TXT 和 JSON。脱水文本和阅读理解将在后续版本实现。

当前版本包含翻译吗?

暂不包含文案翻译。Medium 是多语言识别模型,可识别中文、英语及其他支持语言;把结果翻译成另一种语言计划放在 2.0。

为什么安装包约 100 MB,首次还要下载组件?

约 100 MB 的安装包只包含桌面应用。首次运行会自动下载合计约 3.14 GiB 的 FFmpeg、CUDA/cuDNN GPU Runtime、Whisper Medium FP16、OCR Runtime 和 PP-OCRv6 中英模型,并逐项进行 SHA-256 校验。Large-v3 不参与默认下载;用户无需安装 Python、CUDA Toolkit 或访问 GitHub。